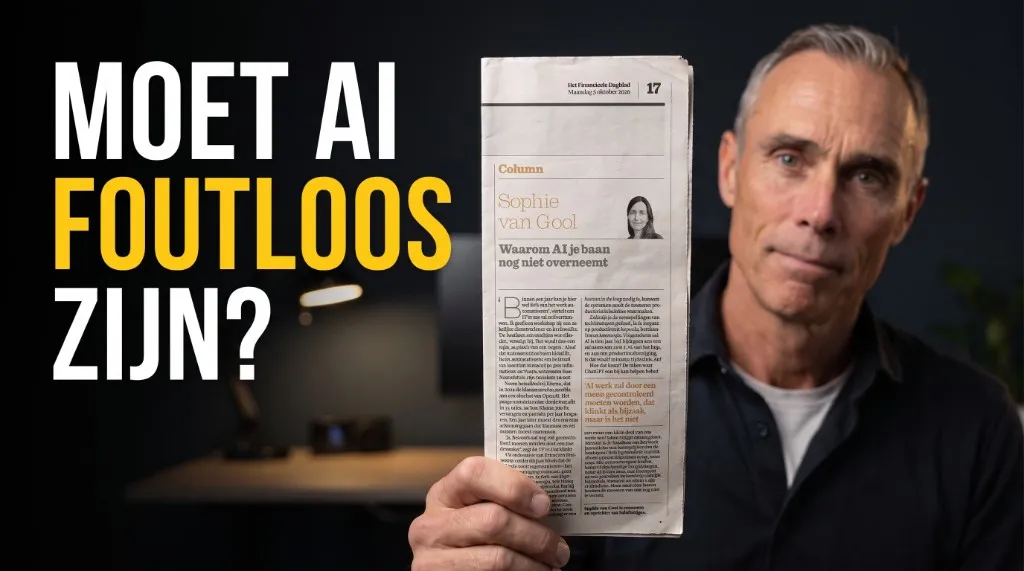
Op 5 oktober 2026 las ik in het FD een column van econoom Sophie van Gool. Volgens haar zijn de beste AI-agents in onderzoek van Princeton maar in 80% van de gevallen betrouwbaar, en daarom moet je ze 100% van de tijd controleren.
Dat klopt, maar ik mis één vraag in haar redenering. Hoe vaak zit je eigen medewerker fout bij precies hetzelfde werk, en wie controleert hem eigenlijk?
TL;DR
- AI maakt fouten, mensen ook. Bij complex denkwerk zit een mens in 2 tot 5% van de handelingen fout.
- We beoordelen AI strenger. Onderzoekers noemen dat algorithm aversion.
- De bruikbare vraag. Zit AI minder vaak fout dan de mens die het werk nu doet?
- Meet eerst je eigen team. De meeste bedrijven die ik spreek doen dat niet.
Is AI betrouwbaar genoeg voor je bedrijf?
AI is betrouwbaar genoeg voor een taak zodra hij daar niet vaker fout zit dan de medewerker die het werk nu doet, en je zijn fouten minstens zo snel kunt vinden. Honderd procent foutloos halen je eigen collega's ook niet. Wie die norm alleen aan AI oplegt, vergelijkt een machine met een mens die nooit fouten maakt.
Van Gool heeft op één punt gelijk, en dat wil ik vooraf zeggen. Een fout van AI ziet er net zo zelfverzekerd uit als een goed antwoord. Je weet dus niet van tevoren welk antwoord fout is, en dat maakt controleren lastig. Maar haar conclusie, dat je daarom alles moet controleren, gaat uit van een vergelijking die ze niet maakt. Ze meet alleen de AI, en laat de mens ernaast buiten beschouwing.
Hoeveel fouten maakt AI echt?
Eerst het cijfer uit de column, want daar zit een misverstand in. Het onderzoek van Princeton heet Towards a Science of AI Agent Reliability (opent in nieuw venster) en is geschreven door onder anderen Sayash Kapoor en Arvind Narayanan. Zij meten hoe betrouwbaar een agent werkt, en dat is een andere vraag dan hoe vaak hij een fout antwoord geeft. Geeft hij bij dezelfde vraag steeds hetzelfde antwoord, blijft hij goed werken als je de vraag iets anders stelt, en weet hij zelf wanneer hij het niet weet?
Op die score haalden Claude Opus 4.5 en Gemini 3 Pro allebei 85%, meldde Fortune (opent in nieuw venster). De belangrijkste conclusie van de onderzoekers vind ik zelf nog interessanter dan dat cijfer. Nieuwe modellen worden snel slimmer, maar hun betrouwbaarheid groeit veel langzamer mee. Een agent die vaker het goede antwoord geeft, is daardoor niet vanzelf een agent die je zonder controle kunt laten werken.
Hoe vaak AI echt fout zit, hangt sterk af van de taak. Een paar voorbeelden laten dat zien.
Samenvatten van een tekst die je aanlevert. Vectara test hoe vaak modellen iets verzinnen als ze een document samenvatten. Op de ranglijst van mei 2026 (opent in nieuw venster) zit het beste model op 1,8%. De bekende topmodellen van OpenAI, Google en Anthropic zitten tussen ongeveer 7 en 12%.
Programmeervragen. Onderzoekers van Purdue lieten ChatGPT 517 vragen van Stack Overflow beantwoorden, en 52% van de antwoorden bevatte een fout (opent in nieuw venster). Dat cijfer wordt nog vaak gedeeld, maar het onderzoek gebruikte GPT-3.5 met vragen uit maart 2023. Het zegt dus weinig over de modellen die je vandaag gebruikt.
Eén uitkomst van Purdue blijft wel relevant. In een kleine gebruikerstest misten de programmeurs in 39% van de gevallen de fout in het antwoord van de AI, omdat het antwoord zo verzorgd en overtuigend was geschreven. Daar zit volgens mij het echte probleem met AI-fouten.
Hoeveel fouten maakt een mens?
Dit is de helft van de vergelijking die in de meeste discussies ontbreekt. Over menselijke fouten bij computerwerk is veel bekend, alleen staat het zelden naast de cijfers over AI.
De Amerikaanse onderzoeker Raymond Panko heeft tientallen jaren gemeten hoe vaak mensen fouten maken in spreadsheets. Zijn overzicht van het onderzoek (opent in nieuw venster) laat zien dat mensen bij complex denkwerk in ongeveer 2 tot 5% van de handelingen een fout maken. Dat lijkt weinig, maar een groot rekenmodel bestaat uit duizenden handelingen. In een van zijn experimenten bouwden 35 studenten in hun eentje een eenvoudig spreadsheet, en 86% van die spreadsheets bevatte minstens één fout.
Twee dingen uit dat onderzoek vind ik belangrijker dan de percentages. Ervaring hielp nauwelijks: studenten zonder ervaring en mensen met minstens 250 uur spreadsheetwerk maakten ongeveer even vaak fouten. En de makers onderschatten hun eigen foutkans sterk. Ze schatten de kans op een fout in hun model tussen de 10 en 18%, terwijl het overgrote deel een fout bevatte.
Ook het controleren van werk gaat bij mensen minder goed dan we denken. Kimberly Barchard en Larry Pace lieten in 2011 bijna 200 proefpersonen gegevens invoeren en daarna op verschillende manieren controleren. Nalezen met het oog leverde nauwelijks minder fouten op dan helemaal niet controleren (opent in nieuw venster). Pas als twee mensen dezelfde gegevens apart invoerden en een computer de verschillen opspoorde, daalde het aantal fouten sterk.
Dat raakt direct aan het advies uit de column. "Controleer AI 100% van de tijd" klinkt veilig, maar als die controle bestaat uit een collega die de tekst doorleest, dan vangt die collega maar een deel van de fouten. Bij het werk van mensen bleek precies die manier van controleren al slecht te werken.
Waarom beoordelen we AI strenger dan mensen?
Als mensen 2 tot 5% fouten maken en ik daar in een MT zelden iemand over hoor, waarom schrikken we dan wel van AI die af en toe fout zit? Onderzoekers hebben dat gemeten.
In 2015 publiceerden Berkeley Dietvorst, Joseph Simmons en Cade Massey een onderzoek met een titel die het al samenvat: mensen mijden algoritmes ten onrechte nadat ze ze een fout hebben zien maken (opent in nieuw venster). Proefpersonen verloren veel sneller vertrouwen in een algoritme dat een fout maakte dan in een mens die dezelfde fout maakte. Ze kozen daarna vaker voor de mens, ook als het algoritme aantoonbaar beter voorspelde. De onderzoekers noemen dat algorithm aversion: een afkeer van algoritmes zodra ze één keer misgaan.
Bij zelfrijdende auto's zie je hetzelfde in cijfers. Onderzoekers vroegen 499 Chinese respondenten hoe veilig een zelfrijdende auto moet zijn voordat ze hem accepteren. Het antwoord, gepubliceerd in Risk Analysis (opent in nieuw venster): vier tot vijf keer zo veilig als een menselijke bestuurder. Een auto die even veilig rijdt als jij en ik, vonden ze niet goed genoeg.
Ik snap dat gevoel. Bij een collega weet je wie de fout maakte, je kunt het erover hebben en je ziet of hij ervan leert. Bij een systeem weet je vaak niet waarom de fout ontstond. Toch kun je op dat gevoel geen bedrijfsnorm bouwen. Als je eist dat AI vier keer zo goed werkt als je medewerkers voordat je hem iets toevertrouwt, laat je ondertussen elke dag werk liggen dat hij al beter doet dan je huidige proces.
De zaak van Klarna wordt vaak genoemd als bewijs dat AI-klantenservice niet werkt, ook in de column. Het betaalbedrijf liet in 2024 een groot deel van de chats door AI afhandelen en nam later weer mensen aan. Maar topman Sebastian Siemiatkowski gaf zelf een andere oorzaak (opent in nieuw venster): kosten hadden bij de inrichting te zwaar gewogen, en daardoor was de kwaliteit gedaald. Klarna leert je dus vooral iets over de manier waarop je AI inzet.
Volg mij op LinkedIn
Moet je AI altijd controleren?
Hier ben ik het deels met Van Gool eens. Een AI-fout is lastiger te vinden dan een menselijke fout, en dat verschil telt mee.
Mensen maken vaak voorspelbare fouten. Iemand is moe aan het eind van de dag, typt een cijfer verkeerd of slaat een regel over, en een collega herkent dat soort fouten. AI maakt fouten die er precies zo uitzien als goede antwoorden, in nette zinnen en met een overtuigende uitleg erbij. Dat zagen we bij Purdue, waar programmeurs bijna vier op de tien fouten misten.
Een groot onderzoek van Harvard Business School en de Boston Consulting Group laat zien wat dat kan kosten. In 2023 kregen 758 adviseurs van BCG verschillende opdrachten, met en zonder GPT-4. Bij taken die binnen het kunnen van AI lagen, leverden ze meer dan 40% betere kwaliteit en werkten ze 25% sneller (opent in nieuw venster). Bij een taak die net buiten dat kunnen lag, kwamen de adviseurs met AI juist 19 procentpunt minder vaak tot het goede antwoord. Ze namen de analyse van de AI over zonder die zelf goed te controleren.
Daarom is human in the loop zo'n belangrijk begrip. Het betekent dat er een mens meekijkt voordat het werk van AI gevolgen krijgt. Maar het woord zegt niets over hoe die mens meekijkt, en daar gaat het vaak mis. Eerder schreef ik al over toezicht op AI-agents die je niet meer kunt meelezen (opent in nieuw venster), en hetzelfde probleem speelt hier op kleinere schaal.
Ik zie dat in mijn eigen werk. Ontwikkelaars bouwen met AI ongeveer tien keer sneller, maar de collega's die het werk testen en goedkeuren, testen niet tien keer sneller. De controle is dus het nieuwe knelpunt geworden. Als je dan alles laat controleren door iemand die het met het oog naleest, verlies je de snelheidswinst, terwijl die controle toch maar een deel van de fouten vangt.
Bij een AI-chatbot die ik heb laten bouwen, voert de bot zo'n 3.000 gesprekken met klanten per maand, en bij 7% daarvan neemt een collega het over. Die overdracht is het belangrijkste deel van het ontwerp. De bot hoeft niet alles te kunnen, zolang hij herkenbaar doorgeeft wat hij niet kan. Je bouwt de controle dan in op de plek waar de risico's zitten, in plaats van alles na te lezen.
Toch heb ik zelf ook een gat in mijn cijfers. Van de bot weet ik precies hoe vaak hij een gesprek doorgeeft, maar hoe vaak de klantenservice vóór de bot fout zat, weet ik niet. Daarmee zit ik in dezelfde positie als de meeste managers die ik spreek, en daarom begint de norm hieronder met die vraag.
Hoeveel fouten mag AI maken? Een norm in drie vragen
Op de vraag uit de titel geef ik daarom antwoord met een vergelijking die je per taak maakt, aan de hand van drie vragen.
1. Hoe vaak zit de mens nu fout bij deze taak?
Dit is de vraag die ik in bijna elke discussie over AI-fouten mis. De meeste bedrijven die ik spreek, weten niet hoe vaak hun eigen medewerkers fout zitten bij het werk dat ze aan AI willen geven. Ze leggen AI daardoor naast een foutloze collega die in hun eigen cijfers niet bestaat.
Meet het daarom eerst. Neem een steekproef van honderd afgeronde dossiers, mails of berekeningen van je eigen team en laat iemand ze grondig nakijken. Dan heb je een bruikbaar vergelijkingspunt. Pas daarna kun je zeggen of 5% fouten bij AI te veel is.
2. Kun je de fouten van AI even snel vinden?
Een AI die even vaak fout zit als je medewerker, maar waarvan je de fouten slechter herkent, is in de praktijk minder betrouwbaar. Kijk dus ook naar hoe je fouten opspoort. Een goede controle vergelijkt de uitkomst met iets anders: een tweede systeem, een regel die een cijfer naast de bron legt, of een steekproef met een vaste checklist. Nalezen alleen is te zwak, dat bleek bij mensen al.
3. Wat kost één fout?
Een fout in een interne samenvatting kost een paar minuten. Een fout in een juridisch advies, een premieberekening of een betaling kan veel meer kosten. Hoe hoger de prijs van één fout, hoe strenger je norm en hoe meer controle je inbouwt. Voor werk met weinig risico mag AI best wat vaker fout zitten dan een mens, als hij het tien keer sneller doet.
Kost menselijke controle de winst van AI?
Van Gool schrijft dat het werk van AI door een mens gecontroleerd moet worden, en dat dat minder bijzaak is dan het klinkt. Daar ben ik het mee eens. Waar ik het niet mee eens ben, is de conclusie dat dit de winst van AI grotendeels tenietdoet. Die conclusie klopt alleen als je de huidige werkwijze als foutloos beschouwt, en dat is ze niet.
Mijn advies aan managers is daarom eenvoudig. Stel de vraag "is AI betrouwbaar?" nooit meer zonder de tweede vraag erbij: betrouwbaar vergeleken met wie? Zolang je dat antwoord niet hebt, weet je niet of AI te vaak fout zit, en weet je eigenlijk ook niet hoe goed je eigen team het doet.
Bronnen
- Column van Sophie van Gool, "Waarom AI je baan nog niet overneemt", Het Financieele Dagblad, 5 oktober 2026 (papieren editie, p. 17)
- Princeton-onderzoek naar betrouwbaarheid van AI-agents: arxiv.org (opent in nieuw venster) (opent in nieuw venster)
- Betrouwbaarheidsscores van 85% voor Claude Opus 4.5 en Gemini 3 Pro: fortune.com (opent in nieuw venster) (opent in nieuw venster)
- Hallucinaties bij het samenvatten van documenten, stand mei 2026: github.com/vectara (opent in nieuw venster) (opent in nieuw venster)
- Purdue-onderzoek naar ChatGPT-antwoorden op programmeervragen: dl.acm.org (opent in nieuw venster) (opent in nieuw venster)
- Raymond Panko over menselijke foutpercentages in spreadsheets: arxiv.org (opent in nieuw venster) (opent in nieuw venster)
- Barchard en Pace over controlemethoden bij gegevensinvoer: sciencedirect.com (opent in nieuw venster) (opent in nieuw venster)
- Dietvorst, Simmons en Massey over algorithm aversion: chicagobooth.edu (opent in nieuw venster) (opent in nieuw venster)
- Liu, Yang en Xu over de veiligheidseis voor zelfrijdende auto's: onlinelibrary.wiley.com (opent in nieuw venster) (opent in nieuw venster)
- Klarna-topman over de oorzaak van lagere kwaliteit: entrepreneur.com (opent in nieuw venster) (opent in nieuw venster)
- Harvard Business School en Boston Consulting Group over de grillige grens van AI: mitsloan.mit.edu (opent in nieuw venster) (opent in nieuw venster)